Faire entrer six sources qui n’ont rien en commun
Chaque source a son format, son rythme et ses pièges : archives compressées, fichiers tableurs dans un vieil encodage, flux d’actualité, agendas, requêtes sémantiques, authentification à jetons. Chacune a son module d’ingestion, et toutes débouchent sur le même modèle de données.
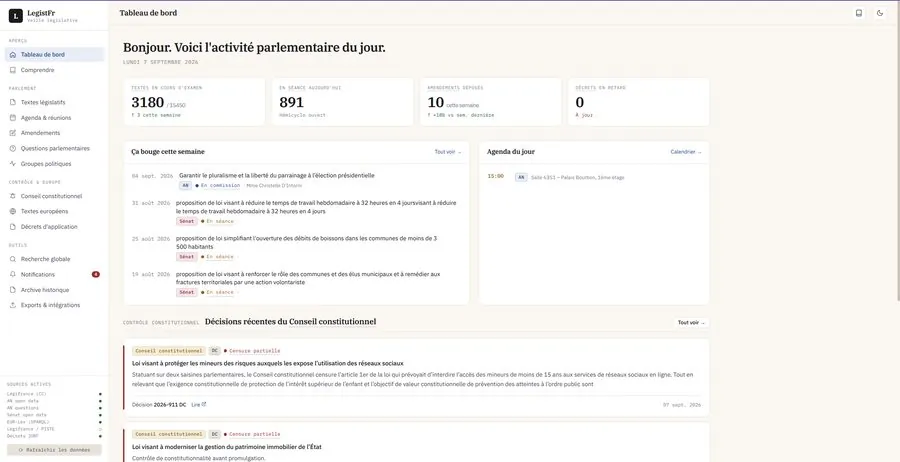
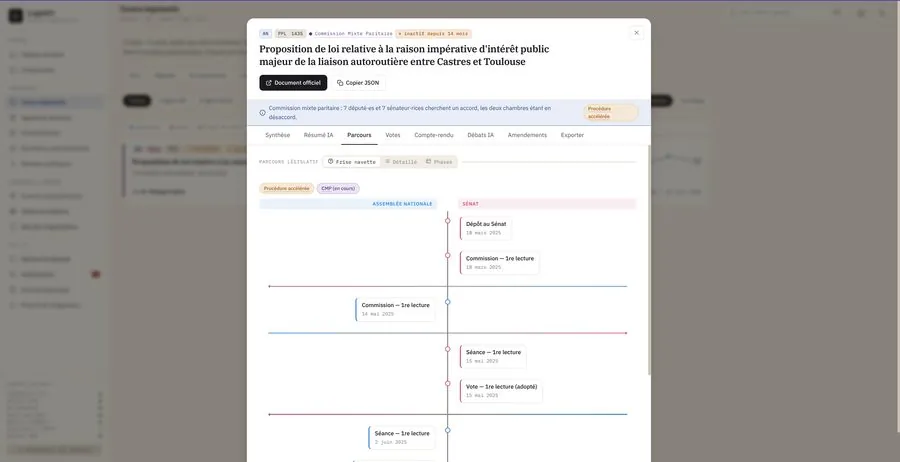
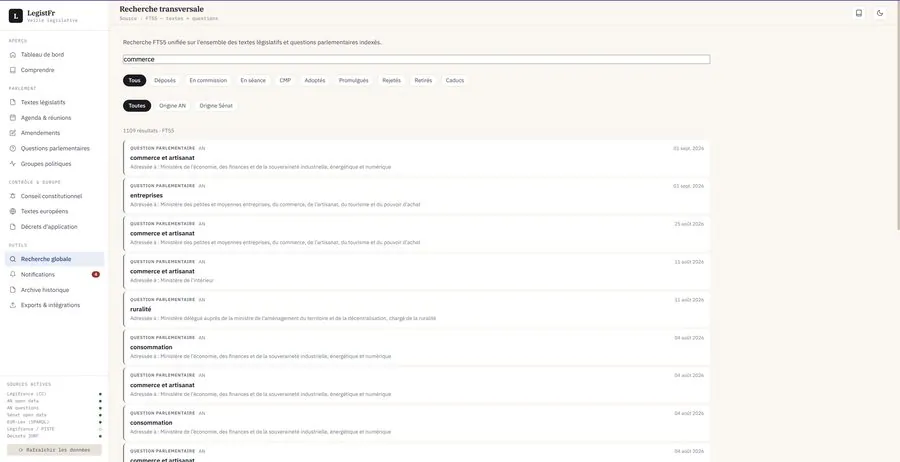
En base aujourd’hui : 15 499 dossiers législatifs, 23 268 questions parlementaires, 7 351 scrutins, 7 176 réunions, auxquels s’ajoutent les textes européens et les décisions du Conseil constitutionnel. La collecte repasse toutes les heures et reprend là où elle s’était arrêtée.
- 15 499dossiers législatifs
- 23 268questions parlementaires
- 7 351scrutins
- 7 176réunions
Six sources, six formats, un seul modèle
- Archive compresséeà décompresser avant de lire
- Tableurdans un encodage d’un autre âge
- Flux d’actualitéqui ne garde que le récent
- Agendaau format calendrier
- Requêtes sémantiquesun langage inconnu hors du milieu
- Authentification à jetonsà renouveler tout seul
Un même modèle de donnéesC’est la partie que personne ne voit, et celle qui commande tout le reste.
La normalisation est la partie ingrate du travail : personne ne la voit, elle ne donne aucune capture d’écran présentable, et c’est là que part le plus gros du temps.
C’est pourtant elle qui commande le reste. Une interface se refait en une semaine ; un modèle de données bancal se paie pendant des mois. J’ai donc écrit la collecte avant l’écran, et l’interface est venue se poser sur des données déjà propres.